
功能说明
LivingMemory 的目标不是简单保存聊天记录,而是把对话转化为可以检索、可以衰减、可以被 Agent 主动使用的长期记忆。
自动总结
达到触发轮次后,插件会让 LLM 将最近对话总结为结构化记忆,并写入长期记忆库。
富检索内容
检索内容由 summary + key_facts 组装,保证信息密度;persona_summary 面向记忆注入、面板展示和人格表达。
主动记忆工具
Agent 可以主动调用 recall_long_term_memory 搜索旧记忆,或调用 memorize_long_term_memory 写入稳定事实。
记忆原子化
关键事实会拆成独立原子,每个原子都有类型、TTL、重要性、访问次数和衰减状态。
记忆从哪里来?
插件有两种写入路径:
| 路径 | 触发方式 | 适合内容 |
|---|---|---|
| 自动反思 | 对话达到配置的总结轮次 | 长期偏好、项目上下文、关系、稳定事实 |
| Agent 主动写入 | 模型调用 memorize_long_term_memory | 用户明确要求“记住”、关键约定、长期任务 |
| 管理员手动总结 | /lmem summarize [message_count] | 立即保存当前上下文,或重新总结最近 N 条消息 |
总结产出的人格化 summary 同时用于记忆注入与面板展示(persona_summary),检索内容由代码从 summary 和 key_facts 组装,避免单一压缩摘要损失信息密度;自定义提示词也可以额外输出事实型 canonical_summary,供图抽取等场景使用。达到原文保留阈值的记忆还会把来源消息独立写入 SQLite;这些原文不进入检索索引,但可用于 Dashboard 核验、重新总结,以及 Agent 主动回忆时的深度回溯。
记忆如何被召回?
用户发送消息后,插件会在 LLM 请求前执行检索。检索结果可以追加到用户消息、放到消息前后,或模拟工具调用注入到上下文。
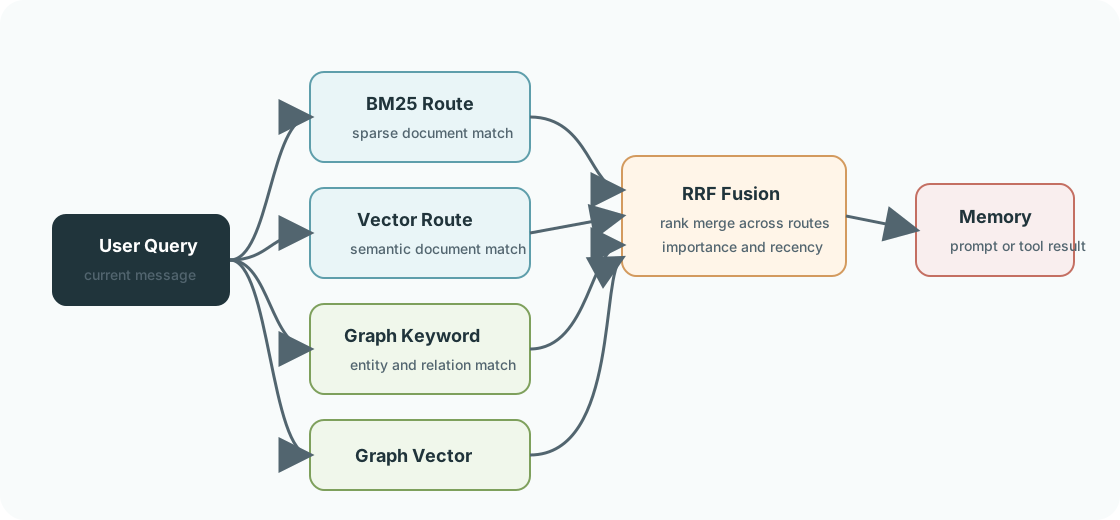
召回结果会综合这些因素排序:
| 因素 | 说明 |
|---|---|
| 关键词命中 | BM25 和图谱关键词能快速找到明确实体或短语 |
| 语义相似 | 向量检索适合找表达不同但含义接近的记忆 |
| 图谱关系 | 实体、关系和跨记忆边能补上“人、事、物”的结构关联 |
| 重要性 | 用户偏好、长期约定等高重要性内容更容易被保留和召回 |
| 时间衰减 | 旧记忆不会永久占据高权重,除非被反复访问或强化 |
| 检索边界 | 可按最低重要性、最低向量相似度和记忆类型过滤候选 |
| 近期保留 | 为当前作用域内的近期记忆预留槽位,避免只依赖相似度排名 |
| 最近上下文 | 可拼接限定时间范围内的最近对话,减少跨话题误召回 |
自主回忆(可选 Beta)
agent_tools.enable_agentic_recall_beta(默认关闭,需同时开启 agent_tools.enable_recall_tool)把主动回忆扩展为单次请求内的多轮检索:
| 能力 | 行为 |
|---|---|
| 按人检索 | target="current_speaker" 查询当前发言人的经历;start_time/end_time 按事件时间过滤;exclude_ids 与 search_offset 支持游标分页 |
| 证据深读 | read_memory_evidence 返回记忆的有效事实,以及整段原文对当前会话可验证时保留的原文;事实与原文均可按游标续读 |
| 共享预算 | 工具调用次数、累计工具耗时与单次返回长度共享单次请求预算,耗尽后模型基于已取得的证据作答 |
| 追加式规则 | 回忆规则提示词以临时片段注入,不进入对话历史与插件消息库 |
关闭该开关时,工具注册、检索与提示词行为与默认实现一致。
谁可以访问哪些记忆?
记忆边界在写入和召回两端统一生效:
| 能力 | 行为 |
|---|---|
| 记忆作用域 | session 按会话隔离,user 允许同一平台用户跨群聊与私聊共享,global 全局共享;legacy 保留旧行为 |
| 强制隔离 | 指定会话始终使用自己的独立作用域,优先于共享模式 |
| 记忆白名单 | 限制哪些用户、群组或完整会话可以捕获、总结、召回和调用 Agent 记忆工具 |
| 身份别名 | 在总结前把平台身份映射为稳定名称;图谱参与者也会优先复用稳定身份,而不是按昵称重复建点 |
作用域变更只影响升级后新写入的记忆,不会自动迁移已有数据。
生命周期如何工作?
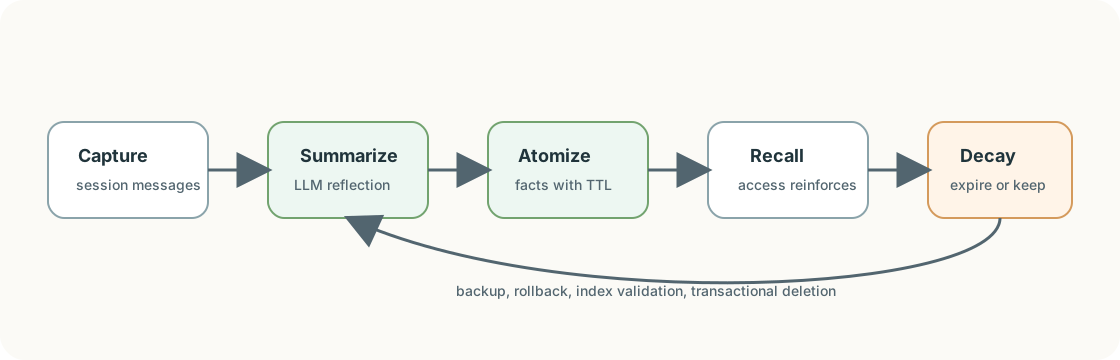
LivingMemory 会定期处理长期记忆:
| 机制 | 作用 |
|---|---|
| 重要性衰减 | 让过旧、低价值记忆逐渐降低权重 |
| 访问强化 | 被反复召回的记忆会获得更高保留价值 |
| 原子 TTL | 不同类型事实拥有不同生命周期 |
| 自动清理或归档 | 低价值记忆可以永久删除,也可以移出检索索引后保留为可恢复归档 |
| 重要记忆保护 | 达到配置阈值的记忆不参与每日重要性衰减 |
| 原文保留 | 高重要性记忆可保留来源消息,用于审计与重新总结 |
| 安全备份 | 版本更新和迁移前自动备份,降低升级风险 |
归档记忆不会参与正常召回;在 Dashboard 恢复后,插件会重新生成 Embedding,并重建 BM25、图谱和原子等派生索引。
大规模索引维护如何保证可用?
插件启动后会在后台检查文档、向量、BM25 和图谱索引,不会因为大量待修复数据阻塞插件就绪:
| 机制 | 作用 |
|---|---|
| Provider 指纹 | Embedding Provider 或模型变化时触发完整向量代际重建,而不只比较向量维度 |
| 分批与断点 | 限制读取批量、Embedding 批量、并发和请求间隔;完整向量重建可从检查点继续 |
| 影子索引 | BM25、FAISS 和图谱先在独立代际中构建,完成后再切换;失败时继续使用线上索引 |
| 并发写入补偿 | 重建结束后再次检查一致性,并补偿维护期间新增或修改的数据 |
| 状态可见 | /lmem status 显示检查、重建、部分完成、失败和取消状态及进度 |